粒影生物的“数据新基建”:干湿实验数据规模超国际同级万倍
- 转载
- 浏览
- 2026-09-22 16:41
粒影生物的“数据新基建”:干湿实验数据规模超国际同级万倍
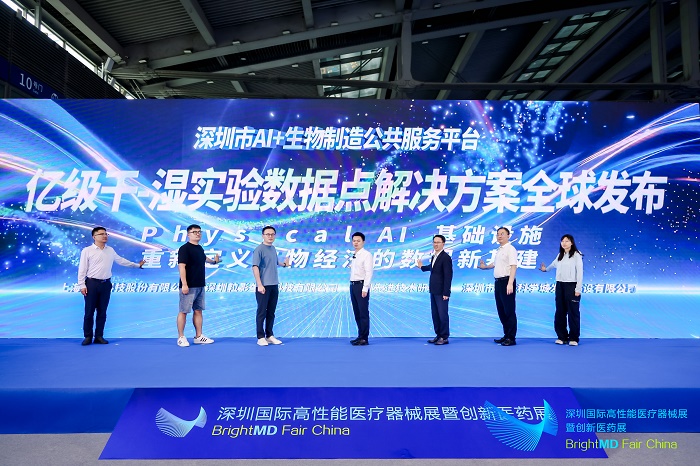
本报深圳9月21日电 在2026深圳国际高性能医疗器械展上,一套面向AI+生物制造领域的干-湿实验数据基础设施方案正式发布。该方案由深圳粒影生物科技有限公司牵头,联合上海思朗科技股份有限公司、深圳先进技术研究院、深圳市光明科学城发展建设有限公司共同推出,试图解决当前AI制药领域高质量实验数据匮乏的瓶颈。
人类社会的每一次产业跃迁,都伴随着基础设施的更替。蒸汽时代的铁路、电气时代的电网、信息时代的光纤与5G——基础设施的层级,决定了产业发展的天花板。生物制造正在迎来这样一个时刻:随着AI向生命科学领域加速渗透,数据的质量与规模,正取代传统经验与试错,成为决定研发效率的核心变量。
然而,与互联网时代"取之不尽"的文本数据不同,生物制造领域的高质量实验数据极度稀缺——它需要真实的物理实验来产出,成本高昂、周期漫长、标准不一。研发团队指出,当前行业面临三重困境:数据孤岛化,各实验室与企业间格式标准各异,难以汇聚成规模化训练集;数据无闭环,传统手工实验通量低、人为误差大,模型学到的往往是实验"噪音"而非真实规律;数据低质量,设计、构建、测试环节割裂,模型预测无法通过实验快速验证修正。
"垃圾数据,只能产出垃圾模型。"研发团队表示,没有高质量的数据底座,再先进的AI算法也难以在生物制造领域真正落地。
过去二十年,AI的主要战场在数字世界,搜索、推荐、语音、图像,数据可以低成本大规模获取。但生物制造不同,研究对象是物理世界的分子与细胞,每个数据点都需要真实实验产出。这意味着,AI在生物制造领域的落地,不能简单复制数字世界的路径,而必须构建一套持续产出高质量物理数据的基础设施。
针对这一挑战,研发团队提出了D²BTL闭环新范式。传统的DBTL(设计—构建—测试—学习)循环隐含一个前提:输入的数据是高质量的。新范式在循环前端增加了"Data"维度,将数据质量治理从隐式假设升级为显式的第一性原则,形成"数据—设计—构建—测试—学习"的完整闭环。依托这一机制,"设计→合成→验证"可实现24小时迭代,AI模型由持续产出的高质量实验数据实时驱动。
在具体能力上,干实验端搭建了AI+生物制造公共服务平台Proteincraft,覆盖蛋白质序列设计、三维结构预测、表达前可溶性与稳定性预判、全原子分子动力学模拟等环节,模拟速度达到国际T1水平。湿实验端采用自研无细胞蛋白表达系统(CFPS),将传统活细胞表达需要两周以上的周期压缩至数小时至一天,可支持膜蛋白、毒蛋白、大蛋白、纳米抗体等高难度蛋白表达。
据介绍,该系统已成功表达GPCR七次跨膜蛋白、刺突蛋白、蛋白转位酶等多种高难度膜蛋白——这类蛋白是传统表达体系的难点,也是药物研发中最重要的靶点类别之一。同时,系统可实现2至3个非天然氨基酸的定点插入,用于抗体偶联药物定点偶联、多肽药物代谢稳定性改造等场景。
算力方面,方案采用了上海思朗科技自主研发的"天穹"科学计算机,打破了美国Anton系列超级计算机在蛋白质动态研究领域对中国科研机构的长期禁用。目前"天穹"已在国内规模化部署20台,获得中国信通院全国最高等级算效认证。
与此同时,方案与深圳合成生物研究重大科技基础设施深度协同。该设施以自动化集成架构,整合高通量移液、智能机械臂、生化分析及无人化物流,构建模块化"智能功能岛"系统,数据由功能岛24小时不间断产出,支持96孔、384孔板大规模并行操作。深圳先进技术研究院与研发团队联合开发酶工程自动化实验方法体系,推动酶工程研发从"手工操作为主"向"自动化、智能化驱动"转型。
有业内专家评价,AI+生物制造的竞争,本质上是高质量数据的竞争。这套方案的价值在于,将干实验的智能设计与湿实验的高通量验证打通成闭环,使AI模型不再依赖零散、滞后的公开数据集。从靶点发现到抗体工程,从酶定向进化到多肽药物优化,亿级高质量数据点的持续供给,有望大幅缩短创新药物和高性能医疗器械的研发周期,降低试错成本。
本文关键字:粒影生物
本文地址:http://www.yiyaotoutiao.cn/yytt/2039.html
 tNGS技术:感染检测“快准稳”的核心密码医药日报1
 金融教育宣传月|瑞众保险通辽中支:多维宣教进基层 织密群众金融安全防护网健康头条2
 百家医道:共襄盛会,乘势开启互联网医疗新篇章!医药日报3
- 医药日报曲江区家庭医生签约服务智能化建设项目启动
- 医药日报百家医道创始人受邀参加龙层花教授学术思想研讨会
- 医药日报百家医道:共襄盛会,乘势开启互联网医疗新篇章!
- 医药日报tNGS技术:感染检测“快准稳”的核心密码
- 医药品牌私密抗衰设备厂家选哪家好?2026年机构选型看这几个关键点
- 健康头条健康相伴 公益同行|粽香传情护肌肤,专业科普守护老年皮肤健康
- 健康头条思展20周年献礼:2026“国际儿童基础汉字认读大赛”报名正式开启
- 医药日报“同心共耀,约创辉煌”好医生云医疗集团药约約核心大客户年度答谢会圆满落幕
- 健康头条金融教育宣传月|瑞众保险通辽中支:多维宣教进基层 织密群众金融安全防护网
- 健康头条适配大湾区老龄化特征的老年髋部骨折居家康复护理路径研究
- 医药日报广东有了一支关注合理用药的专家队伍